Die Hardware steht, die Grafikkarte ist bestellt, und nun stellt sich die eigentliche Frage: Welches Sprachmodell soll darauf laufen? Bei Open-Weight-Modellen, deren Gewichte man herunterladen und als lokales LLM selbst betreiben kann, ist die Auswahl groß und ändert sich fast monatlich. Dieser Beitrag zeigt Geschäftsführern und IT-Verantwortlichen, nach welchen Kriterien sie ein Modell für den eigenen Server auswählen und wie sie selbst prüfen, ob es für ihre Aufgaben taugt.
Was Open-Weight-Modelle sind, und was nicht
Ein Open-Weight-Modell ist ein Sprachmodell, dessen trainierte Gewichte, also die gelernten Zahlenwerte, öffentlich zum Download bereitstehen. Sie können es auf eigener Hardware betreiben, ohne dass Anfragen an einen Cloud-Anbieter gehen. Im Sprachgebrauch heißen solche Modelle oft „Open Source LLM“. Streng genommen trifft das nur zu, wenn auch Trainingsdaten und Trainingscode offenliegen, was selten der Fall ist, und die Lizenz kann Einschränkungen enthalten. Das Gegenstück sind geschlossene Modelle, die nur über die Schnittstelle des Herstellers nutzbar sind; dort verlassen Ihre Daten zwangsläufig das Haus. Für den Betrieb im Unternehmen ist vor allem die Lizenz entscheidend.
Warum ein LLM lokal betreiben? Vorteile und Grenzen
Open-Weight-Modelle lohnen sich vor allem aus zwei Gründen: Die Daten bleiben im eigenen Haus oder im Rechenzentrum Ihres Dienstleisters, was bei Personal-, Mandanten- oder Konstruktionsdaten oft den Ausschlag gibt (siehe KI und Datenschutz im Unternehmen). Und es fallen keine Gebühren pro Anfrage an, die Kosten liegen in Hardware und Betrieb. Dem stehen Grenzen gegenüber: Sie brauchen passende Hardware und jemanden, der das System betreibt, und die größten geschlossenen Modelle sind bei sehr anspruchsvollen Aufgaben oft weiterhin stärker. Für klar umrissene Aufgaben im Unternehmensalltag reicht ein gut gewähltes offenes Modell dagegen meist aus.
Kriterium 1: Größe und Grafikspeicher
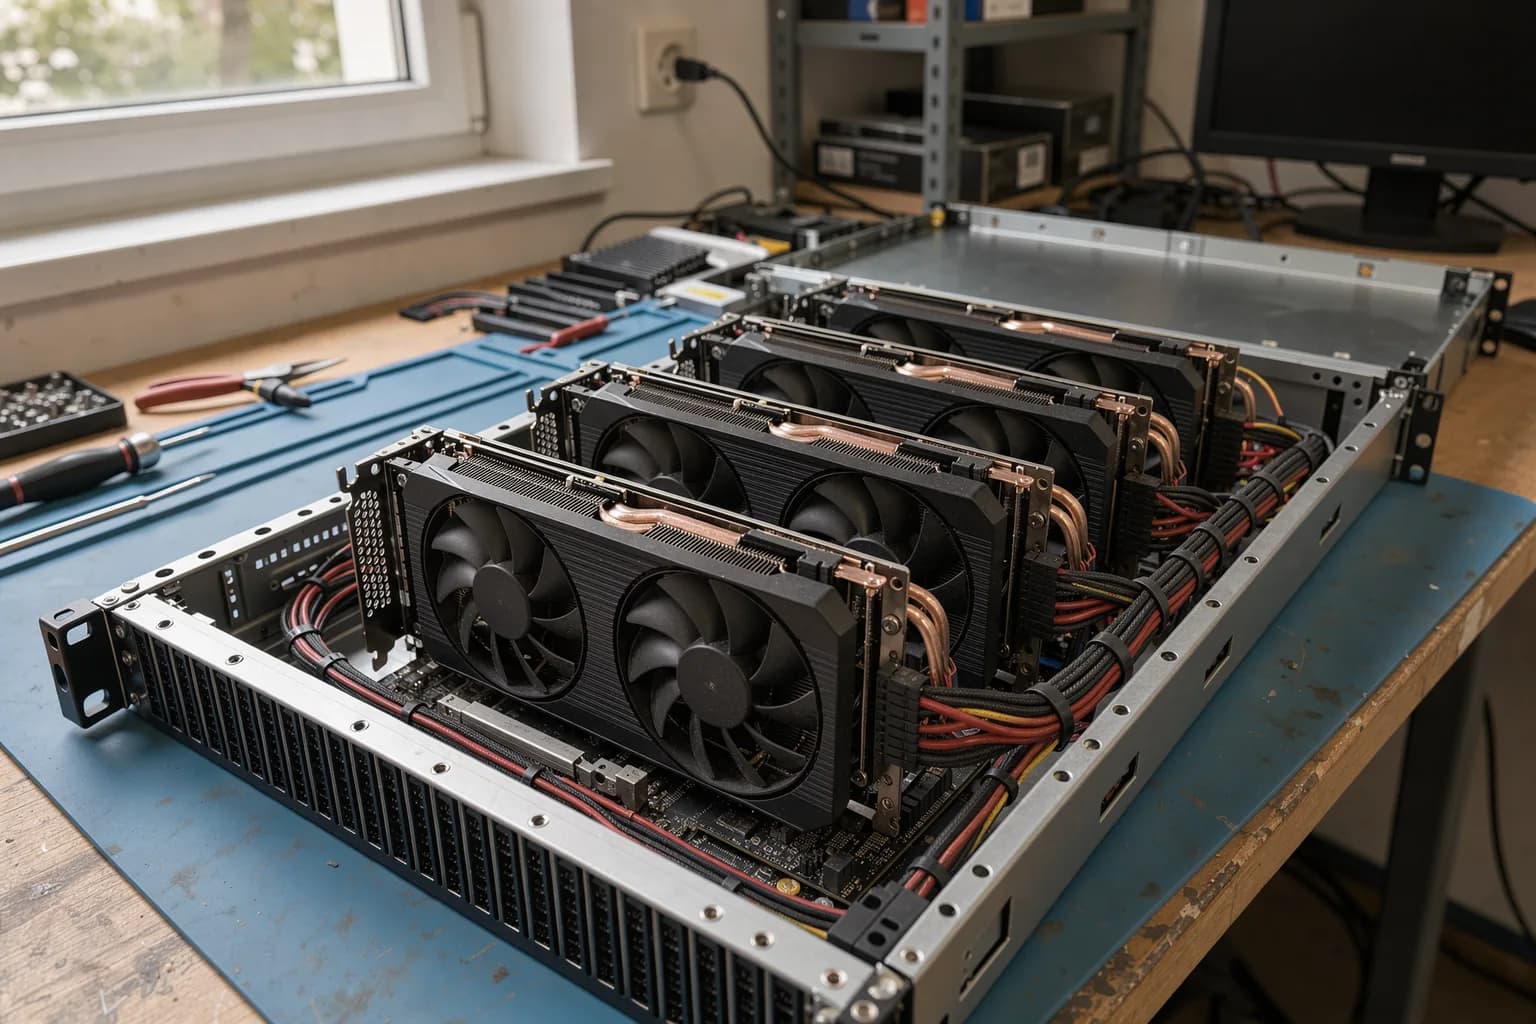
Die Größe eines Modells wird in Parametern angegeben, etwa 8, 27 oder 120 Milliarden („8B“, „27B“, „120B“). Grob gilt: Je mehr Parameter, desto mehr Wissen und Sprachgefühl, aber auch desto mehr Grafikspeicher (VRAM) wird benötigt. Als Faustregel braucht jeder Parameter in voller 16-Bit-Genauigkeit zwei Byte. Ein 27B-Modell belegt damit allein für die Gewichte rund 54 GB, in 4-Bit-Quantisierung etwa ein Viertel davon. Hinzu kommt Speicher für den Kontext und für gleichzeitige Anfragen.
Ein Sonderfall sind Mixture-of-Experts-Modelle (MoE). Sie haben viele Parameter, von denen pro Wort aber nur ein Teil aktiv ist. Das macht sie schneller, den Speicher für alle Gewichte brauchen sie trotzdem.
Wie Sie den Grafikspeicher für Ihre Nutzerzahl konkret planen, beschreibt der Beitrag Lokale Sprachmodelle: Grafikspeicher richtig planen. Eine erste Abschätzung liefert unser GPU-Rechner.
Kriterium 2: Deutschkenntnisse
Viele Modelle werden überwiegend mit englischen Texten trainiert. Das merkt man nicht unbedingt an Grammatikfehlern, sondern an Feinheiten: holprige Formulierungen, englische Satzstellung, falsche Fachbegriffe, Duzen statt Siezen oder Schwierigkeiten mit deutschem Steuer- und Arbeitsrecht. Kleinere Modelle sind davon stärker betroffen als große.
Herstellerangaben zur Mehrsprachigkeit helfen nur bedingt, und öffentliche Bestenlisten messen meist englische Aufgaben. Verlässlich ist nur der eigene Test mit Ihren eigenen Texten, siehe unten.
Kriterium 3: Lizenz
Hier lohnt der genaue Blick, denn die Lizenzen unterscheiden sich erheblich.
- Apache 2.0: Eine verbreitete, freizügige Lizenz. Gewerbliche Nutzung, Anpassung und Weitergabe sind erlaubt, Bedingungen sind im Wesentlichen Lizenz- und Urheberhinweise. Für Unternehmen ist das die unkomplizierteste Variante.
- MIT-Lizenz: Ähnlich freizügig wie Apache 2.0.
- Eigene Lizenzen der Hersteller: Manche Anbieter verwenden eigene Lizenztexte mit zusätzlichen Pflichten. Die Llama-4-Lizenz von Meta verlangt zum Beispiel einen sichtbaren Hinweis „Built with Llama“, wenn man das Modell weitergibt, und eine Sondergenehmigung ab 700 Millionen monatlich aktiven Nutzern. Wichtiger für deutsche Unternehmen: Die zugehörige Nutzungsrichtlinie räumt Personen und Unternehmen mit Sitz in der EU die Rechte an den multimodalen Llama-4-Modellen ausdrücklich nicht ein.
Prüfen Sie die Lizenz immer an der Modellkarte der konkreten Version, die Sie einsetzen wollen, nicht nur an der Modellfamilie. Innerhalb einer Familie können verschiedene Größen oder Versionen unterschiedlich lizenziert sein. Bei Unklarheiten sollte ein Anwalt die Lizenz im Einzelfall bewerten.
Kriterium 4: Kontextlänge
Die Kontextlänge gibt an, wie viel Text das Modell in einer Anfrage gleichzeitig verarbeiten kann, gemessen in Tokens (Wortbestandteilen). Für kurze Fragen und E-Mail-Entwürfe reichen wenige tausend Tokens. Wer lange Verträge, Handbücher oder mehrere Dokumente auf einmal auswerten will, braucht deutlich mehr.
Zwei Einschränkungen sollten Sie kennen: Erstens kostet langer Kontext zusätzlichen Grafikspeicher, oft mehr als erwartet. Zweitens nimmt die Qualität bei sehr langen Eingaben bei vielen Modellen ab, auch wenn das Datenblatt eine große Zahl nennt. Für Wissensdatenbanken ist deshalb häufig die Kombination aus Suche und Modell (RAG, also das gezielte Nachladen passender Textstellen) sinnvoller als ein riesiges Kontextfenster.
Kriterium 5: Quantisierung
Quantisierung bedeutet, dass die Gewichte mit weniger Genauigkeit gespeichert werden, zum Beispiel mit 8 oder 4 Bit statt 16 Bit. Das spart viel Speicher und macht das Modell meist schneller. Der Preis ist ein gewisser Qualitätsverlust, der bei 8 Bit in der Praxis oft kaum auffällt und bei 4 Bit je nach Modell und Aufgabe spürbar werden kann.
Eine häufige Abwägung lautet daher: lieber ein größeres Modell in 4 Bit oder ein kleineres in voller Genauigkeit? Das entscheidet nur der Test mit Ihren eigenen Aufgaben.
Bekannte Open-Weight-Modelle nach Familien, Stand Oktober 2026
Ohne Rangliste und ohne Anspruch auf Vollständigkeit: Diese Familien sind derzeit im Unternehmensumfeld verbreitet. Lizenzangaben nach öffentlich verfügbaren Übersichten und Herstellerangaben, bitte vor dem Einsatz an der Modellkarte prüfen.
- Qwen (Alibaba): Seit Qwen3 werden die offenen Modelle unter Apache 2.0 veröffentlicht, 2026 folgten Qwen3.5 und Qwen3.6 in mehreren Größen.
- Mistral (Mistral AI, Frankreich): Mehrere Modelle unter Apache 2.0, darunter Mistral Small 4 aus dem März 2026. Nicht alle Modelle des Herstellers stehen unter derselben Lizenz.
- Gemma (Google): Gemma 4 erschien im April 2026 erstmals unter Apache 2.0, in vier Größen bis 31B. Ältere Gemma-Versionen nutzen eigene Nutzungsbedingungen.
- gpt-oss (OpenAI): Zwei offene Modelle mit 20B und 120B Parametern, veröffentlicht im August 2025 unter Apache 2.0.
- Llama (Meta): Llama 4 steht unter einer eigenen Community-Lizenz mit den oben beschriebenen Einschränkungen.
- DeepSeek: Mehrere Modelle unter MIT-Lizenz, allerdings in Größen, die für typische Unternehmensserver meist zu groß sind.
Welches dieser Modelle für Sie am besten passt, lässt sich nicht aus einer Liste ablesen. Entscheidend sind Ihre Aufgaben, Ihre Hardware und Ihre Qualitätsansprüche.
So testen Sie selbst
Eigene Testfragen zusammenstellen
Sammeln Sie 20 bis 40 echte Aufgaben aus Ihrem Alltag, zum Beispiel: eine Kundenanfrage beantworten, ein Protokoll zusammenfassen, eine E-Mail höflich ablehnen, Daten aus einer Rechnung herauslesen, eine Frage zu Ihrem internen Handbuch beantworten. Achten Sie auf eine Mischung aus einfachen und schwierigen Fällen. Verwenden Sie keine echten personenbezogenen Daten, solange das Testsystem nicht abgesichert ist.
Zu jeder Frage eine Musterlösung festlegen
Schreiben Sie vorher auf, was eine gute Antwort enthalten muss. Sonst bewertet man im Nachhinein nach Bauchgefühl.
Unter gleichen Bedingungen vergleichen
Testen Sie alle Kandidaten mit denselben Fragen, derselben Systemanweisung und vergleichbarer Quantisierung. Lassen Sie die Antworten möglichst von Fachleuten aus der jeweiligen Abteilung bewerten, idealerweise ohne zu wissen, welches Modell geantwortet hat.
Auch Geschwindigkeit und Verhalten prüfen
Messen Sie, wie lange eine typische Antwort dauert, wenn mehrere Personen gleichzeitig fragen. Prüfen Sie außerdem, wie das Modell reagiert, wenn es etwas nicht weiß: Sagt es das, oder erfindet es eine plausible Antwort?
Checkliste / Erste Schritte
- Konkrete Einsatzzwecke festlegen, etwa Texte entwerfen, Dokumente durchsuchen, Daten extrahieren.
- Verfügbaren Grafikspeicher und erwartete Nutzerzahl klären.
- Lizenz jedes Kandidaten an der Modellkarte der konkreten Version prüfen.
- Benötigte Kontextlänge abschätzen und RAG als Alternative prüfen.
- Drei bis vier Kandidaten in passenden Quantisierungen auswählen.
- 20 bis 40 Testaufgaben mit Musterlösungen erstellen.
- Blind bewerten lassen und Antwortzeiten unter Last messen.
- Entscheidung dokumentieren und nach sechs bis zwölf Monaten neu bewerten.
Wie DAVINCI unterstützt
Wir beraten Sie bei der Auswahl passender Modelle, richten Testumgebungen ein und betreiben Ihr Sprachmodell auf einem KI-Server in unserem Rechenzentrum oder bei Ihnen vor Ort. Was beim Eigenbetrieb zu beachten ist, lesen Sie im Beitrag zum KI-Server im Eigenbetrieb. Für ein erstes Gespräch nutzen Sie gern unser Kontaktformular.
Häufige Fragen
Ist ein größeres Modell immer besser?
Nicht zwingend. Größere Modelle sind meist stärker bei komplexen Aufgaben und bei Deutsch, aber langsamer und teurer im Betrieb. Für klar umrissene Aufgaben wie Zusammenfassen oder Daten extrahieren kann ein mittelgroßes Modell völlig ausreichen.
Dürfen wir Open-Weight-Modelle gewerblich nutzen?
Das hängt von der Lizenz ab. Modelle unter Apache 2.0 oder MIT erlauben die gewerbliche Nutzung grundsätzlich. Bei herstellereigenen Lizenzen gibt es teils Einschränkungen, etwa regionale Ausschlüsse oder Kennzeichnungspflichten. Lassen Sie im Zweifel einen Anwalt draufschauen.
Welche Software brauchen wir, um ein LLM lokal zu betreiben?
Neben dem Modell selbst eine Laufzeitumgebung, oft Inferenz-Server genannt, die die Gewichte in den Grafikspeicher lädt und eine Schnittstelle für Anwendungen bereitstellt. Dazu kommen je nach Einsatz eine Oberfläche für die Mitarbeiter, die Anbindung an Ihre Dokumente per RAG sowie Zugriffsschutz, Protokollierung, Updates und Monitoring.
Wie oft sollten wir das Modell wechseln?
Ein Wechsel lohnt nur, wenn ein neues Modell bei Ihren eigenen Testfragen spürbar besser abschneidet oder weniger Hardware braucht. Wer seine Testsammlung aufhebt, kann neue Open-Weight-Modelle mit überschaubarem Aufwand vergleichen.
Verwandte Themen: Wer hier weiterdenkt, liest bei Eigener KI-Server, RAG und KI-Server weiter.