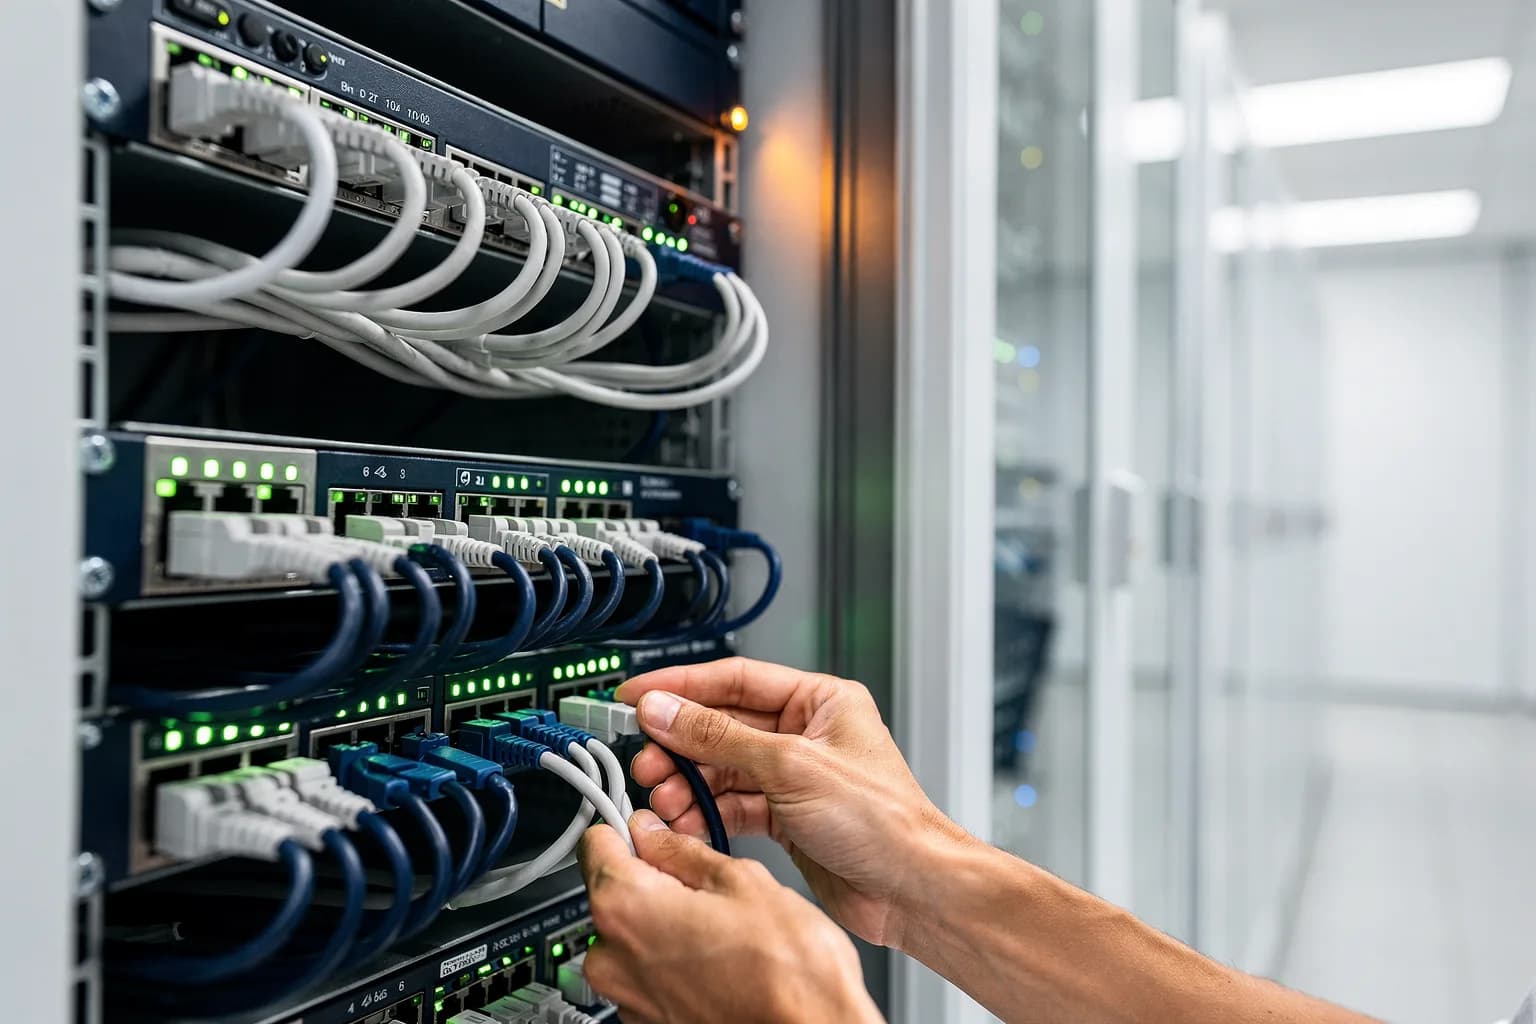
Worum es in diesem Teil geht: was ein Single Point of Failure ist, wo er sich in einem gewöhnlichen Netzwerk versteckt – und wie wir ihn in diesem Projekt bei Internet und Netzwerk beseitigt haben.
- Internet: dreifach redundant – zwei unabhängige Anbieter plus eigene Mobilfunkanbindung
- Netzwerk: Ausfall eines beliebigen Switches ohne Unterbrechung
- Ausweichpläne: A, B und C, automatisch nacheinander
Was ein Single Point of Failure ist
Ein Single Point of Failure ist eine Stelle, deren Ausfall das Ganze anhält. Eine einzige Internetleitung. Ein einziger Switch, an dem alle Arbeitsplätze hängen. Eine einzige Firewall. Solange diese Stelle funktioniert, merkt niemand etwas. Fällt sie aus, steht alles – egal, wie gut der Rest gebaut ist.
Das Tückische ist, dass solche Stellen selten geplant sind. Sie entstehen, weil eine Lösung einmal genügt hat und nie jemand gefragt hat, was passiert, wenn sie ausfällt.
Wo er sich versteckt
- Die Internetleitung – besonders, wenn alles in der Cloud liegt
- Der zentrale Switch im Serverschrank
- Die Firewall, durch die jeder Datenverkehr muss
- Die Stromversorgung von Schrank und Netzwerk
- Der eine Administrator, der als Einziger weiß, wie alles eingerichtet ist
Internet: dreifach redundant
Für die Beratung haben wir die Internetanbindung dreifach ausgelegt: zwei unabhängige Anbieter und zusätzlich eine eigene Mobilfunkanbindung. Unabhängig heißt dabei mehr als zwei Verträge. Zwei Leitungen, die im selben Kabelkanal ins Haus kommen oder am selben Verteiler hängen, fallen im Ernstfall gemeinsam aus. Deshalb zählt der Weg, nicht der Anbietername.
Fällt eine Leitung aus, übernimmt die nächste. Die Mobilfunkanbindung ist die letzte Stufe – unabhängig von jeder Leitung im Boden.
Netzwerk: kein Switch darf alles anhalten
Im Netzwerk galt dieselbe Regel. Wir haben es so aufgebaut, dass der Ausfall eines beliebigen Switches den Betrieb nicht unterbricht. Dafür braucht es doppelte Wege: Jedes wichtige Gerät ist über zwei Strecken angebunden, und das Netzwerk weiß, welche es nehmen soll, wenn eine fehlt.
Darüber liegen mehrstufige Ausweichpläne – A, B und C –, die automatisch nacheinander greifen. Fällt A aus, übernimmt B. Fällt auch B aus, übernimmt C. Niemand muss nachts aufstehen, um umzustecken; das Netzwerk schaltet selbst um, und wir sehen es in der Überwachung.
Ein Gegenbeispiel aus einer Kanzlei
Wie es ohne Redundanz aussieht, zeigt ein anderer Fall: Eine Steuerkanzlei hatte ihre Kanzleisoftware vollständig in die Cloud ausgelagert. Als die Hauptleitung gestört war, hingen 18 Arbeitsplätze und die Telefonie drei Wochen lang an einem LTE-Router mit wenigen Mbit/s. Die Cloud war erreichbar – nur nicht schnell genug, um damit zu arbeiten.
Was das für Ihr Unternehmen bedeutet
Fragen Sie sich bei jedem Teil Ihrer IT: Was passiert, wenn genau dieses Teil ausfällt? Wo die Antwort „dann steht alles“ lautet, haben Sie einen Single Point of Failure. Die Beseitigung kostet meist weniger, als man denkt – und deutlich weniger als der Tag, an dem er zuschlägt.
Verwandte Themen: Wer hier weiterdenkt, liest bei WLAN, Netzwerksegmentierung und Switch auswählen weiter.